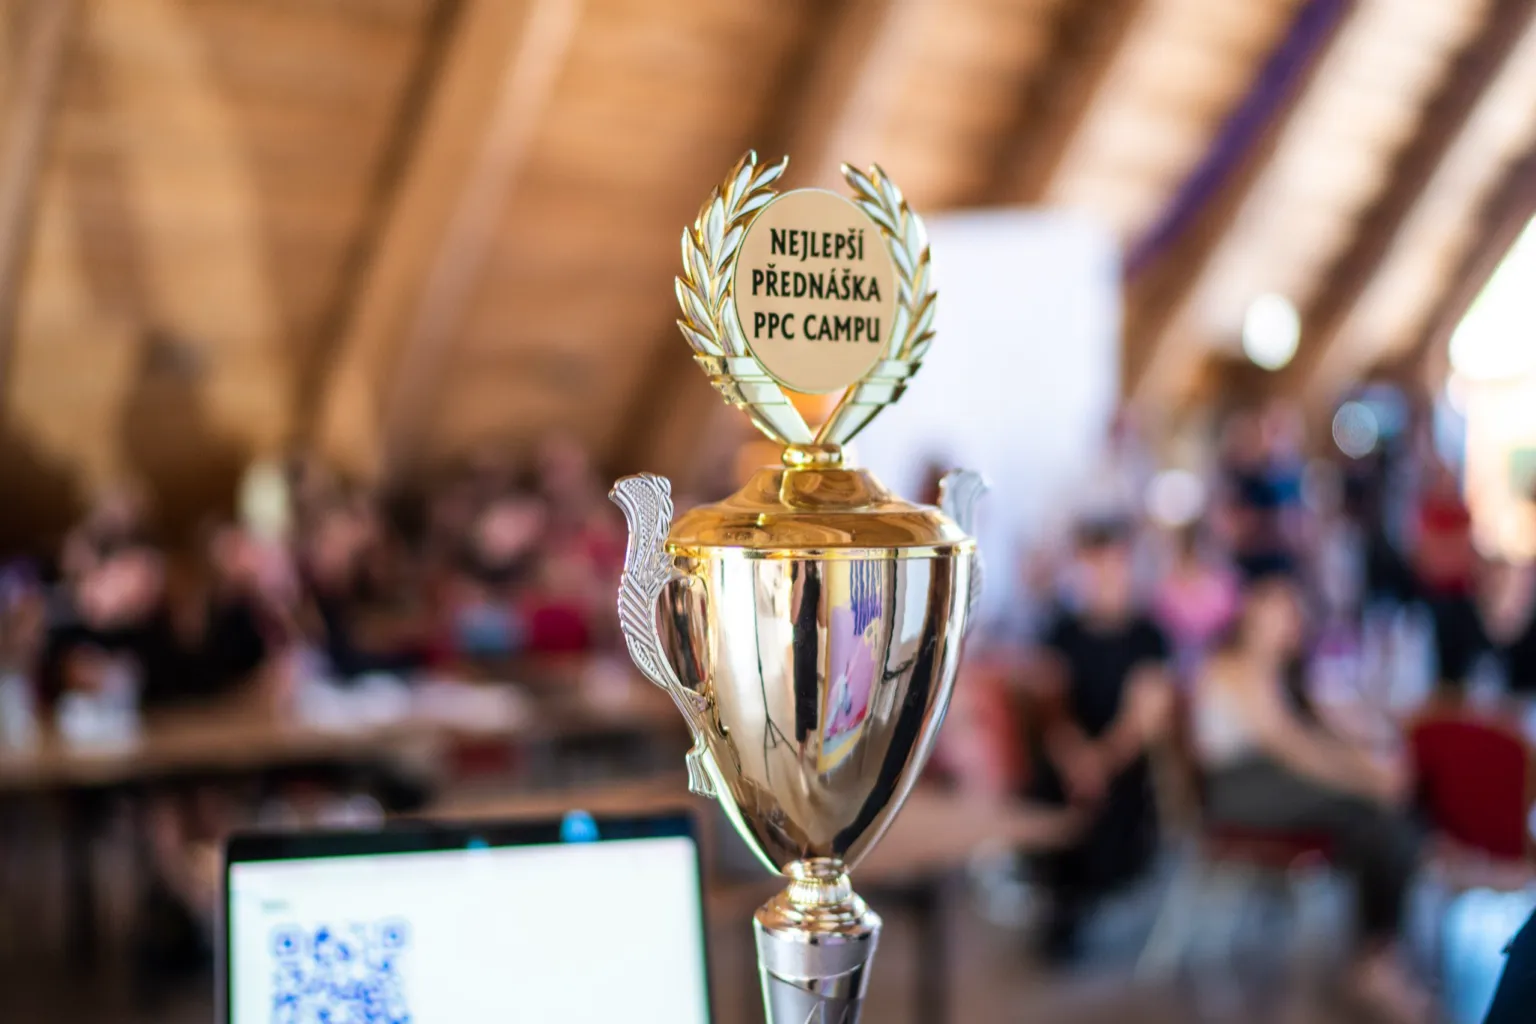
Stručně: 29. srpna 2026 jsem na PPC campu u Telče, konferenci české a slovenské PPC komunity, přednášel o tom, jak naše agentura funguje s AI. Přednáška vyhrála pohár za nejlepší přednášku campu. Tady je krátký report z akce a pod ním celý záznam přednášky, shrnutí každé části a slajdy ke stažení.
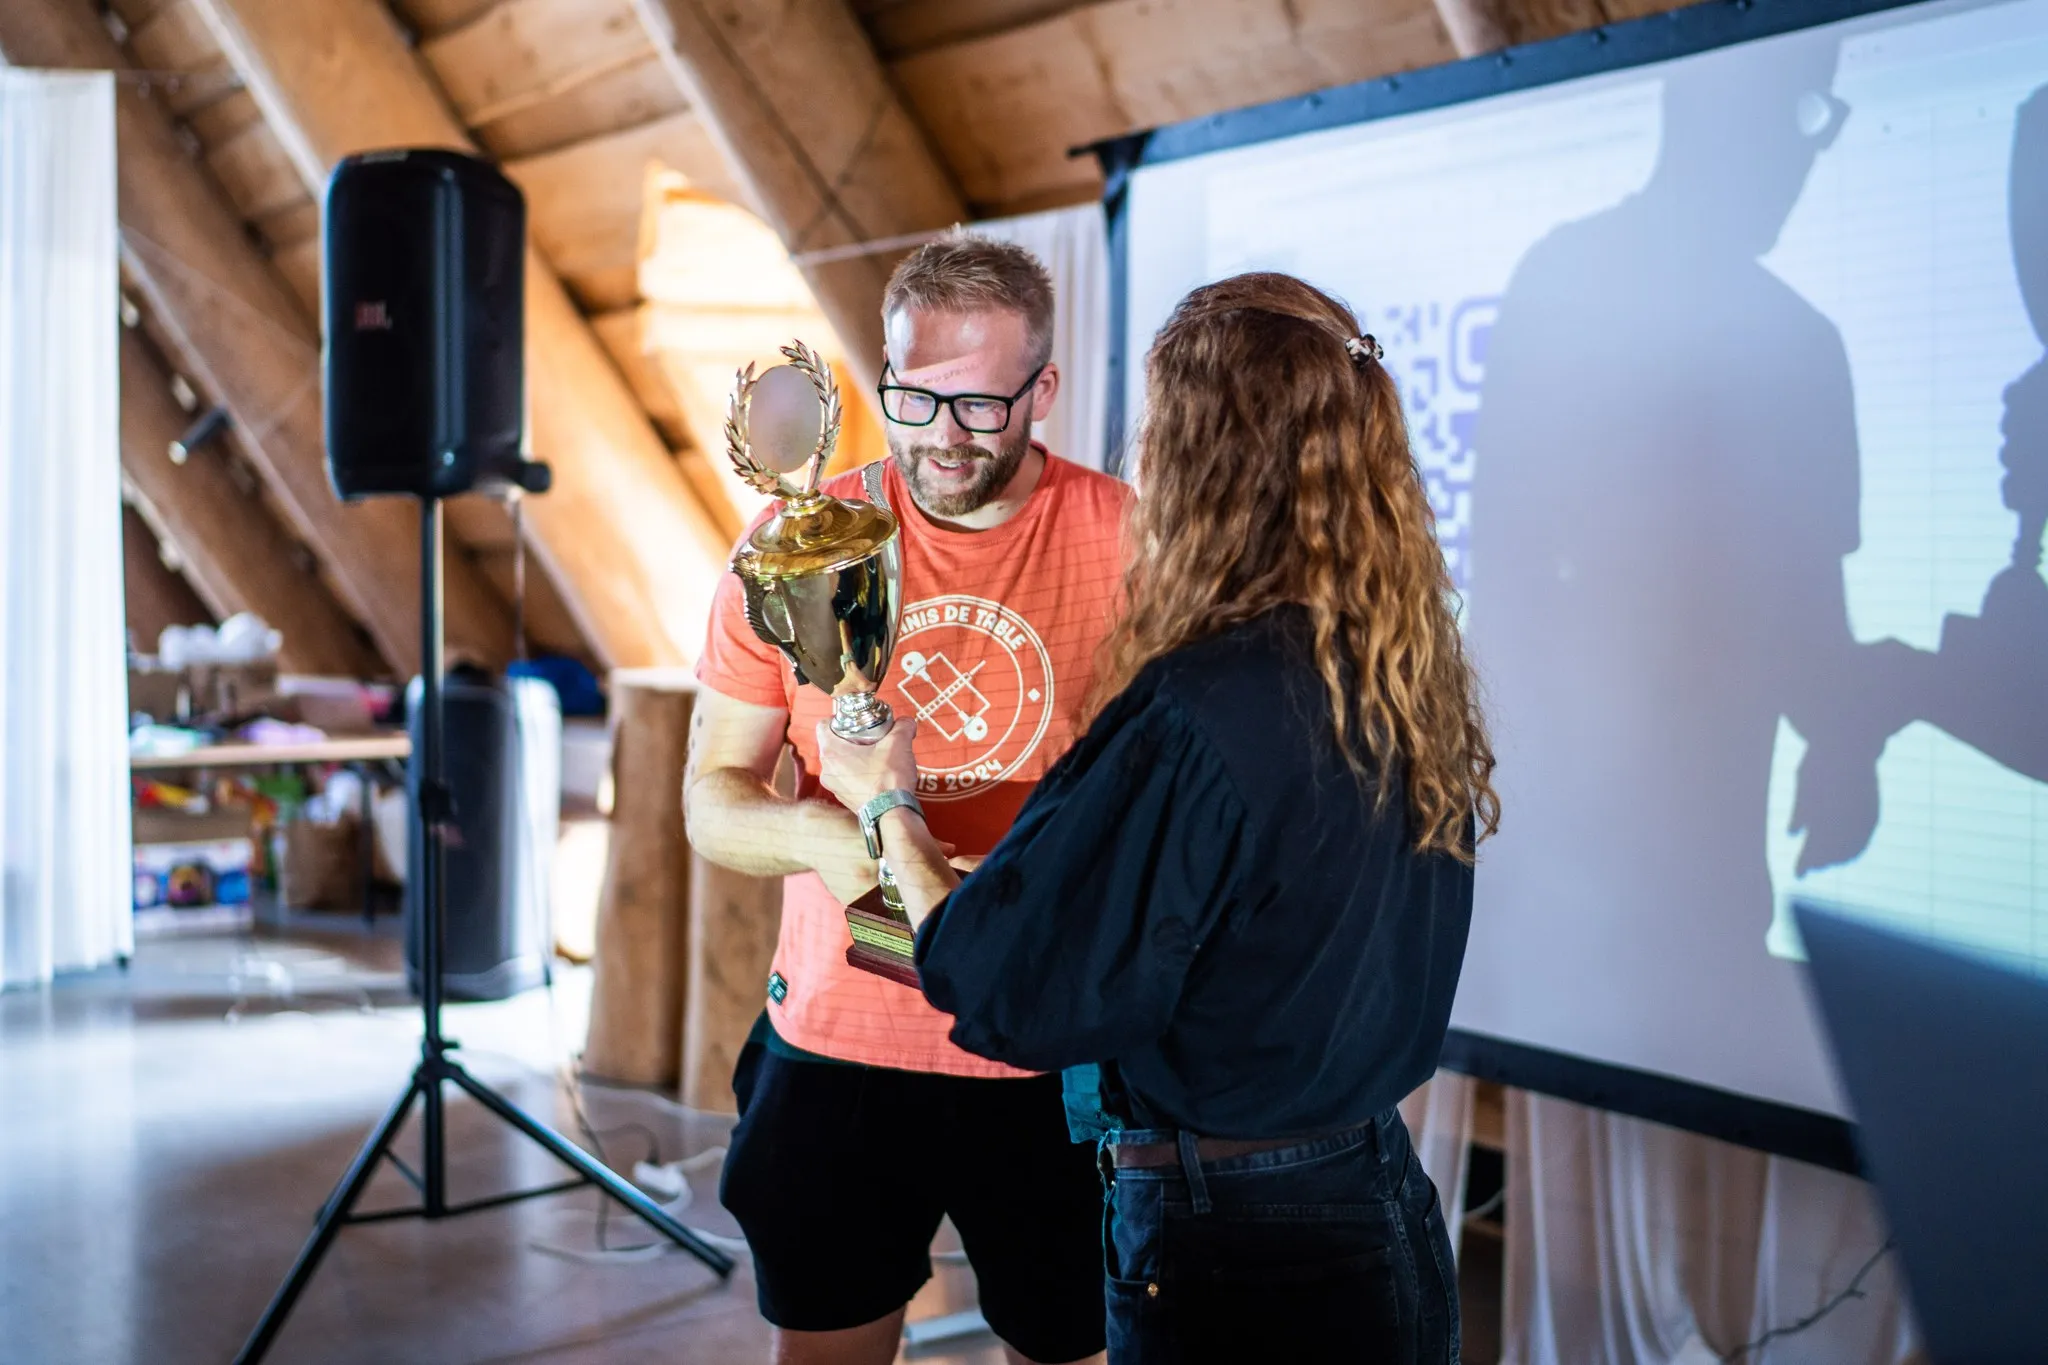
Poslední srpnový víkend jsem strávil tři dny v dřevěném sále u Telče a mluvil o tom, jak naše agentura doopravdy funguje s AI. V neděli jsem jel domů se zlatým pohárem na sedadle spolujezdce. Stojí na něm Nejlepší přednáška PPC campu.
Akce se jmenuje PPC camp a pořádá ji uLab. Podle mě je to nejlepší PPC akce v Česku a na Slovensku. Důvod je jednoduchý. Lístek si koupit nemůžeš. Účastníky schvaluje komunita, takže v sále sedí praktici, kteří mají co sdílet. Přednášky jsou opravdové přednášky, ne čtyřicet minut firemní prezentace. Letos to byl osmnáctý ročník, tři dny od 28. do 30. srpna 2026, asi sedmdesát lidí a dvacet jedna přednášek. Pátek patřil sociálním sítím, feedům a datům, sobota byla celá o AI a neděle se vrátila k datům a měření.
Sedm dalších přednášek, které stojí za odpoledne
Většina řečníků po akci sdílela své prezentace a zápisky uLabu z víkendu na ně odkazují. Tady je sedm, které bych otevřel jako první, ke každé pár vět.
Milan Cidilo (6clickz) (slajdy) řídí kreativy na Metě jako výrobní linku. Koncept je u něj persona krát úhel krát formát. Celé to řídí dvě čísla: podíl testovaných reklam, které jdou do škálování, a inkrementální dosah. Jeho pondělní rutina oštítkuje každou reklamu podle pevné taxonomie, projde pět největších konkurentů v Ad Library a ohodnotí zadání ještě před začátkem výroby.
Anna Czarnoba (Knihobot) (slajdy) má ve feedu zhruba 1,5 milionu knih z druhé ruky. Každá je unikátní fyzický kus s vlastním ID, a to Smart Biddingu pořád nuluje historii konverzí. Feed proto postavila na vydání místo na konkrétním kusu a nabídky na jedno dílo omezila na čtyři. Ověřila to na náhodném rozdělení 4 429 děl metodou difference in differences. ROAS stoupl z 1,686 na 1,819, zatímco kontrolní skupina klesla. Celou pipeline si postavila sama.
Ľubo Kružliak (Wilsondo) (slajdy) vede in-house marketing pro deset e-shopů v šesti zemích. Měl nejkonkrétnější přednášku o datovém skladu z celého víkendu, od kategorií v reportingu a pojmenování kampaní až po to, jak BigQuery rozpočítá náklady na session až na jednotlivé produkty. Zveřejnil i číslo, které většina řečníků vynechá. Vývoj stál 250 000 až 500 000 Kč a provoz stojí 7 500 až 10 000 Kč měsíčně.
Lukáš Hvizdoš (6clickz) (slajdy) sepsal deset workflow z nákupu médií, která zautomatizoval. U každého uvádí statistickou metodu, zdroj v API, ze kterého čte, a výstup, který vytváří. Změny rozpočtu vyhodnocuje jako event study, segmentace Shoppingu na úrovni produktů používá empirical Bayes shrinkage a únavu kreativy datuje detekcí bodu zlomu. Jeden slajd obsahuje celý jeho stack nástrojů a dá se číst jako samostatný seznam literatury.
Vito Nikolič (Mergado) (slajdy) ukázal, jak vypadají statické bannery z feedu, když nesou informace, které nakupující opravdu potřebuje. Nosnost, rozměry, dodací podmínky a hodnocení hvězdičkami, natištěné rovnou na obrázek produktu. Tvrdí, že na takovou kreativu stačí manuál značky a vývojářské nástroje v prohlížeči, bez grafika.
Iveta Dudová (uLab) (slajdy) vysvětlila, proč se rozbíjí měření na Shopify, a to z pohledu PPC specialisty, ne analytika. Checkout extensibility přesunula děkovací stránku do sandboxu. Iveta porovnává tři cesty, které zůstaly otevřené, a končí rozhodovacím stromem, kdy se vyplatí server-side měření.
Pavel Tomáš Řehák (M&M Reality) (slajdy) testoval Viber, Telegram a X s kreativou, která už fungovala na velkých platformách. Měřil celou cestu až po předání leadu prodejní síti v jejich CRM. Ani jedna ze tří platforem se nevyplatila a právě poctivé shrnutí dělá prezentaci užitečnou. Telegram přinesl 926 prokliků, 22 otevření bota a ani jeden lead.
Záznam přednášky
Přednášku natočil uLab a záznam je teď na jeho YouTube kanálu. Je to video nahoře v tomto článku. Pod ním najdeš shrnutí všech částí a slajdy ke stažení. Pro čtenáře, kteří neumí česky, jsem ze zvukové stopy a slajdů vytvořil anglickou verzi přednášky a nechal ji namluvit klonem svého hlasu.
Chceš místo videa slajdy?
Všech 67 slajdů z přednášky v PDF. Nech mi e-mail a prezentace je tvoje. Nebo čti dál shrnutí po kapitolách.
Jeden soubor, jeden seznam. Píšu, jen když je co číst.
- Přístupy do účtů mají všichni stejné. Rozdíl je v tom, co tvoje AI vidí, ještě než se jí na něco zeptáš. Kontext vyhrává nad chytrostí.
- Mantinely patří do kódu, ne do promptu. Operaci mazání, která neexistuje, AI nepřemluví.
- AI nelže ani tak o faktech, jako spíš o tom, co ověřila. Kontrola proto zkoumá důkazy, nikdy závěr.
- Z PPC se stal vývojářský a datový problém. Znalost oboru je vstupenka. Vyhrává ten, kdo umí sáhnout do vývoje a dat.
Přednáška má dvě poloviny. Nejdřív čtyři věci, které musely existovat, aby cokoliv z toho fungovalo. Popisuju je jako části těla, protože se tak dobře pamatují. Pak to, co celý systém doopravdy dělá na účtech, aplikaci po aplikaci.
Část první · Anatomie
Co muselo vzniknout, aby to celé fungovalo
Ruce. Bezpečný přístup k účtům
Všechny čtyři části visí na jedné zásuvce, na našem vlastním MCP serveru. Jeho napsání byl první krok. Komunikuje se všemi kanály, které spravujeme, a čte a zapisuje jen tam, kde smí. Dosáhne do BigQuery, Cloud Storage, našeho timetrackingu, registru klientů, Asany, e-mailu, Slacku a přepisů hovorů s klienty. Protože zapisuje do živých účtů, limity jsou v kódu. Operace mazání neexistuje. Každý zápis běží nejdřív nanečisto. Účet se před zásahem zkontroluje a každý specialista má strop útraty. Každá změna zanechá záznam se stavem před a po. Přístupové údaje zůstávají na serveru. Model dostane výsledek, nikdy klíče.
Oči. Kontext, který chat nemá
Všechny marketingové platformy se každý den nahrávají do jedné databáze a nejpoužívanější pohledy jsou předpočítané. Otázka na vyhledávací dotazy tak trvá sekundy místo stovek dotazů na API. Databáze je zároveň archiv. Historie změn v Google Ads po třiceti dnech zmizí, u nás zůstává roky. Nad tím je náš vlastní crawler klientského webu, pět let byznysového reportingu až na marži jedné objednávky, PostHog pro to, co návštěvníci doopravdy dělají, a DataForSEO pro konkurenci. DataForSEO nahradilo licenci Semrush za zhruba 15 000 Kč měsíčně a stojí 2 000 až 4 000 Kč měsíčně za celou firmu. Kontext je celá hra a část těch dat není nikde veřejně.
Dílna. Kde vznikají kreativy
Statická kreativa začíná u jednoho brandového souboru na klienta. Je v něm manuál, fonty, loga, dřívější kreativy a kreativy konkurence. Kolega pak napíše jednu větu o tom, co má kreativa říct. Banner se skládá ze dvou vrstev a díky tomu je levný. Obrazový model vygeneruje jen pozadí, což je ta drahá část. Všechno ostatní je HTML vrstva nad ním. Můžeš tak změnit font, zvětšit tlačítko, posunout logo nebo všechno přeložit, aniž by se cokoliv generovalo znovu. Video funguje stejně. Pro každou scénu vybíráme z asi pětadvaceti modelů od šesti poskytovatelů. Dvě pravidla platí vždycky. Digitální dvojník jen s podepsaným souhlasem. A produkt vždycky pochází ze schválené fotky ve feedu.
Mozek. Paměť a oponenti
Napsali jsme si vlastní orchestrační vrstvu, místo abychom používali cizí chatovací aplikaci. Jedna session může spustit další a všechno je navázané na úkol. Když session skončí, zdestiluje se do faktů, preferencí, ponaučení a rozhodnutí. Ta jdou do paměti projektu, ne člověka. Sémantické vyhledávání běží nad zhruba pětadvaceti tisíci session a víc než deseti tisíci rešerší, takže bidding, nabídka i strategie najdou tutéž starou práci. Každou noc systém den znovu projde, zneplatní zastaralá fakta a víc váhy dá tomu, co se opravdu používá. A protože modely halucinují, každé kolo práce dostane oponenty. Strážce je úsudek. Mantinel je pravidlo.
Nejužitečnější, co nás oponenti naučili, je, v čem se AI doopravdy plete. Ani ne tak ve faktech, jako v tvrzeních o vlastní práci. Jeden skript hlásil, že Google Ads prokazatelně načetly data o marži. Ověřil přitom jen to, že je po půl jedné. Jiný převrátil převod ROAS a do živé kampaně by zapsal šestnáct set procent. Třetí napsal Vídeň, Bělehrad a ceny z jedenácti zemí, přestože zadání znělo Rakousko, Srbsko a deset trhů. Tvrzené není ověřené. Tenhle vzorec tvoří pětinu všeho, co strážci najdou.
Část druhá · Osm základních aplikací
Co to dělá každý den
1. Reporty, stovky reportů
Reporty jsou první věc, kterou si s tím každý postaví. Živý artefakt je interaktivní stránka, kterou AI sestaví přímo v chatu z předpočítaných dat platforem a z byznysových dat klienta. Dnes jich máme stovky. Jeden každé ráno přepočítá úpravy nabídek podle zařízení napříč pětapadesáti kampaněmi. Úprava a její důvod jsou na stejném řádku. Mobily dolů o třiatřicet procent, desktop dolů o pětačtyřicet. Stejná tabulka o úroveň níž rozbalí kampaň na její čtyři kreativy. Google a Meta vedle sebe, seřazené podle PNO, protože marže se hodně liší. Levná návštěvnost a zisková návštěvnost nejsou totéž.
2. Jedna kreativa, jedenáct jazyků
Tady je vidět, co ty dvě vrstvy přinášejí. Obrazový model se zavolá jednou na pozadí. Jedenáct překladů je jen text v HTML vrstvě, takže se nic negeneruje podruhé. Nástroje za celou sadu stojí 3,5 Kč. Naše plné náklady jsou asi 20 Kč a fakturujeme kolem 50 Kč. Větší výhra je, že se to celé děje v jedné session. Specialista si řekne o nové kreativy. Tatáž session se podívá, jak fungovaly kreativy dřív, a v byznysovém reportu zjistí, jak se produkt prodává. Pak kreativu vyrobí a nahraje. Nikdo neotevře grafický editor a nikdo neotevře správce podkladů.
3. Ranní běh nanečisto
Sada pravidel každé ráno projde každý účet a do půl osmé čekají návrhy. Kam posunout stropy nabídek a cílové návratnosti, které vyhledávací dotazy vyloučit a kam přidat rozpočet, protože se plní cíle. Druhá polovina jen hlídá. Jestli je Merchant Center v pořádku, jestli se obnovil katalog na Metě a jestli nejsou produkty, na které nic necílí. V den, kdy se natáčelo video, prošlo sedmdesát devět kontrol a pět vyžadovalo pozornost. Za nimi čekalo až osmdesát čtyři zásahů. Schvaluje se řádek po řádku. Řádek, který jsi neschválil, se nikdy nespustí. Odškrtávám, komentuju a všechno se ukládá jako podklad pro další kolo.
4. Příprava na call s klientem
Protože všichni vidí všechno, víš i to, co dělal kolega. Před callem s klientem dostaneš jednu stránku. Co se dohodlo, z přepisů hovorů a z cílů. Jaká práce se udělala, z Asany a z deníku zásahů. Pak poctivé shrnutí toho, co se udělalo, co ne a co chybí. V praxi je to jedna otázka: co jsme na projektu udělali za posledních třicet dní a co jsme slíbili na minulém callu. Dvě minuty a máš to. Stejná otázka slouží jako předávka, když kolega odjede na dovolenou a ty převezmeš jeho účty.
5. Texty reklam napsané z webu
Chci odkazy na podstránky, které sedí ke každé kategorii. Normálně je mít nemůžu, protože neznám strukturu webu. Tady je projitý celý web klienta včetně drobečkové navigace. Sestava na dětská kola tak dostane odkazy na podstránky, které opravdu existují. Šestnáctipalcová kola pro nejmenší, skladem. Dvacetipalcová pro šesti až osmileté, skladem. Chat bez tohoto kontextu napíše pro celý účet Akce, O nás a Kontakt. Vidíme taky, co v aukci křičí konkurence. Když všichni křičí dopravu zdarma, odpovím jinde, odborností, zárukou a skladem. Než se cokoliv nasadí, strážci zkontrolují fakta.
6. Zamítnuté produkty, opravené naráz
Merchant Center zamítne produkt, protože má na obrázku překryv, nálepku nebo akční proužek. Opraví to jedna věta. Vezmi původní fotku jako referenci, vygeneruj obrázek bez překryvu, nahraj ho do Cloud Storage, veřejný odkaz dej do doplňkového feedu a naimportuj ho. Žádný grafik, žádný vývojář na straně klienta. Stejný běh projde celý feed najednou. Oprava je ta nudnější polovina. Pak začneš přidávat. Google vezme dalších deset obrázků a pět lifestylových fotek, Meta až dvacet. Většina e-shopů přitom posílá jeden. Druhý obrázek je nejlevnější inventář v účtu. Přinese o sedmdesát šest procent víc zobrazení a o třicet dva procent víc prokliků.
7. Vylučující slova z druhé platformy
Tohle stojí na jednom zjištění. Google skrývá velkou část vyhledávacích dotazů, Sklik ne, a lidé hledají v obou stejně. Dotazy, které v Googlu nevidíš, jsou vidět ve Skliku a z nich vytáhneš kořeny, které stojí za to vyloučit. Čtyři kroky. Dej vyhledávací dotazy z Google Ads, Skliku a Bingu na jedno místo. Z těch viditelných vytáhni kořeny. Když potřebuješ jít hlouběji, rozšiř každý kořen přes našeptávač z DataForSEO. Jeden zápis pak pošle celou strukturu vylučujících slov do všech účtů najednou. Slepé místo jedné platformy bývá vidět na jiné.
8. Atributy feedu vyplněné za tebe
Pro Merchant Center automaticky vyplňujeme sedmnáct doporučených atributů. Název, popis, značku, kódy produktu, barvu, materiál, vzor, velikost, věkovou skupinu, pohlaví a další. Feed klienta nemusí obsahovat ani jeden z nich. Stejné obohacení jde přes doplňkové feedy i do Mety. Tohle je spíš náš produkt než interní nástroj. Jmenuje se Boostora AI, v produkci je přes rok a půl a za sebou má dva roky vývoje. Prodáváme ji samostatně. Je to tedy jediná část stacku, kterou nikdo nemusí stavět. Můžeš ji prostě mít.
Celá prezentace v PDF
Všech 67 slajdů, včetně těch, které shrnutí výše zhušťuje do jednoho odstavce. Nech mi e-mail a je tvoje.
Jeden soubor, jeden seznam. Píšu, jen když je co číst.
Část druhá · Osm pokročilých aplikací
Těžší osmička
Tohle jsou analýzy, které si klient dřív kupoval za skutečné peníze, nebo je nedostal vůbec, protože ručně by je nikdo nezaplatil.
1. Roční plán
Klient chce číslo obratu na celý rok při dané ziskovosti. Pod tím běží Greykite, open-source predikční model od LinkedInu, nad naším byznysovým reportem. Na malých a nových trzích, kde chybí data, ho ručně korigujeme. Výsledkem je plán podle trhu a podle kanálu. Na jedné reálné skupině devíti trhů predikuje skoro čtyřicetiprocentní růst. Simulátor nabídek z Google Ads API ten růst pak nacení na dvacet devět až čtyřicet devět centů v médiích za každé další euro obratu. Ze stejných dat měříme retenci jako počet objednávek na nového zákazníka do tří set šedesáti dnů. Retence je částka, kterou můžeš dát do plánu. Když každý trh pod průměrem dotáhneš na průměr, má to hodnotu až 1,29 milionu eur ročně. Bez jediného eura navíc do médií.
2. GAP analýza
Dva směry se potkají uprostřed. Směrem ven má crawler každou stránku klienta a byznysový report ví, jak která konvertuje. Vytáhneme tak stránky, které se dobře prodávají, a přitom se vůbec neinzerují. Směrem dovnitř vezmeme sto nebo dvě stě klíčových slov, která jsou pro klienta zásadní, a najdeme pět nejbližších organických konkurentů. Pak stáhneme každou vstupní stránku, se kterou se umisťují, a klíčová slova za ní. Spojíme to a vyleze rozdíl. Chybějící vstupní stránky seřazené podle hledanosti, komerční mezery a obsahová témata. Tohle byla analýza, kterou si klient musel koupit za desítky tisíc korun. Teď jsou to dvě hodiny strojového času, zatímco jsi na obědě, a dvacet minut kontroly. Podrobně to rozebírám v samostatném článku.
3. Analýza expanze
Každý e-shop má feed pro Merchant Center a v něm atribut product_type. Když ho deduplikuješ, máš skutečné kategorie e-shopu. Z nich se stanou výchozí klíčová slova, přeložená do jazyků asi deseti kandidátských trhů. Každé jde do průzkumu klíčových slov pro svou zemi. Vrátí se deset až dvacet tisíc návrhů, AI asi polovinu vyhodí a zůstane tabulka, kde má každé klíčové slovo kategorii, zemi, hledanost a cenu za proklik. Trhy pak seřadí devět vah. V jedné zemi byly ceny klienta osm procent pod konkurencí a predikovaný ROAS vyšel 6,1. V jiné byly ceny patnáct procent nad konkurencí a ROAS vyšel 1,1. S ROAS 1 do země nevstupuješ. Celá metoda je popsaná tady.
4. Všechno, co víme o jednom produktu
Vezmi jednu položku. Škrabadlo pro kočky, věž sto padesát centimetrů, 2 390 Kč. Víme, že má marži třicet jedna procent a prodá se ho čtyřicet sedm kusů měsíčně. Víme, že jeho PNO je 9,7 % v Shoppingu a 11,2 % v katalogových kampaních na Metě. Všechno visí na item ID z feedu. Napravo je trh. Podle ceny je tenhle produkt sedmnáctý z třiadvaceti e-shopů a ceny konkurence jdou od 1 690 do 2 690 Kč. Vlastní štítky pak produkty roztřídí do pásem, aby ty dobré dostaly vlastní kampaně. Číslo, které klient potřebuje, je marže minus PNO, nikdy samotné PNO.
5. Konverze z dat PostHogu
Zkusil jsem to u tří nebo čtyř klientů a u každého konverzní poměr znatelně vzrostl. První vrstva je chování z PostHog API: hloubka scrollu, kliky, mrtvé kliky a chyby podle typu zařízení. Jsou to těžká data. Sto tisíc session denně je čtyřicet gigabajtů, takže je celý rok nedržíme. Druhá vrstva je konverzní výzkum a vlastní analytika klienta. Dohromady navrhnou drobné změny. Tahle stránka má problém na mobilu. Sem lidé nikdy nedoscrollují. Tohle tlačítko nic nedělá. Hodina takové práce dopadla velmi podobně jako placený audit od jednoho z nejlepších UX specialistů, které znám. Ten stál 150 000 Kč.
6. Web jako repozitář
U několika projektů jsme přestali stavět obvyklý web na WordPressu. Web je repozitář, statický, postavený v Astru, a celý ho staví AI. Pro klienty ze služeb a softwaru to znamená stovky struktur vstupních stránek na konkrétní dotazy a pořádné testy mezi nimi. Dvě věci k tomu dostaneš zadarmo. Neexistuje veřejná administrace CMS, takže je menší plocha pro útok a méně údržby. A web je rychlý. Důkazem je tenhle blog. Šest nebo sedm hodin designu a vývoje a píšu ho ve čtrnácti jazycích. Každá změna je verzovaná, takže cokoliv jde vrátit během pár minut.
7. Produktová videa do feedu
Katalogové kampaně na Metě berou video a Google taky, jenže skoro nikdo ho ve feedu nemá. My ho děláme z fotky, která už tam je. Deset až patnáct sekund produktu z několika úhlů a pár střihů, za jeden až dva dolary za video. Všechno navrch je překryv: benefity, recenze, cena a závěrečný snímek, vyrenderované jako HTML stejně jako bannery. Video pak jde do doplňkového feedu jako atribut produktu. Protože cena je jen vrstva, noční úloha najde produkty, u kterých se změnila cena nebo dostupnost, a vygeneruje znovu jen překryv. Draze jednou, levně každou noc.
8. Page feedy, které klient nemusí posílat
Naše parametrické DSA cílení potřebuje page feed. Když o něj klienta požádáš, budeš čekat dlouho a často nepřijde vůbec. My prosit nemusíme. Crawler už každou stránku zařadil jako produktovou, kategorii, parametrickou nebo nekomerční. Feedy tak jdou přes Cloud Storage do DSA a Performance Max kampaní v Google Ads. A protože crawler na každé stránce počítá produkty, cílení se přepíná samo. Kategorie, která se vyprázdnila, z feedu vypadne, a ta, která se zase naplní, se vrátí. Ve stejném průchodu je ještě bonus. Na produktové stránce je jedna cena, v Merchant Center jiná, a my ten nesoulad vidíme dřív, než z něj Google udělá zamítnutí.
Co osm měsíců stálo a co přineslo
- Systémy v produkci, používá je asi 20 lidí 7
- Řádky kódu v živých systémech, včetně testů 810 000
- I s předchůdcem, kterého jsme letos také nahradili 1,3 mil.
- Samotný orchestrátor, naceněný postaru 2–3 roky
- Celý ekosystém, naceněný postaru 2 vývojáři × 5 let
PPC už není PPC problém
Zhruba osmdesát procent našeho času bývala rutina. Exporty, klikání, ruční nastavování, procházení dotazů, kontrola reklam. To končí. Jestli teď, nebo za rok, je vlastně jedno. Ručně se to už dlouho dělat nebude. A práce neubylo, je jí víc než dřív. Jen je to konečně práce, která dřív nebyla možná.
Proč se to stalo, je spíš ekonomický argument než technický. Automatizace se dřív musela zaplatit objemem. Dávala smysl firmě s pěti tisíci účty a dvaceti vývojáři. Nástroj na klíčová slova nad Google Ads API, pro které píšu kód dvanáct let, znamenal tři nebo čtyři měsíce práce, jen aby měl produkční kvalitu pro naše vlastní použití. Dnes stejný nástroj zabere tři dny. Nová automatizace trvá týden a běží souběžně s pěti dalšími věcmi. Teď stačí jeden senior s dobrými nástroji.
Znalost oboru je tedy vstupenka a přesah do vývoje a dat je výhoda. PPC pořád rozumět musíš. Jen k tomu potřebuješ i představivost, data, orchestraci a kontrolu. Zbytek odpracuje lopata.
Začni tím, co tvoje AI vidí
Přístupy do účtů mají všichni stejné, takže v nich rozdíl není. Vyber jeden dataset, který tvůj tým pořád dokola stahuje ručně. Nahraj ho někam, kde se ho model zeptá během pár sekund, a sleduj, kolik otevřených otázek se zmenší na jednu větu. U nás to bylo denní nahrávání dat z platforem. Změnilo každou další konverzaci.
Dej mantinely do kódu dřív, než pustíš AI k zápisu
Prompty jsou prosby. Kód je pravidlo. Než začne cokoliv tvého zapisovat do živého účtu, rozhodni, co prostě nesmí existovat, co musí nejdřív proběhnout nanečisto a jaký strop útraty patří komu. Pak schvaluj řádek po řádku, aby se neschválený řádek nikdy nespustil.
Znovu naceň analýzu, kterou jsi před třemi lety odložil
Vezmi tu jednu službu, kterou jsi přestal nabízet, protože by nikdo nezaplatil ty hodiny. GAP analýzu, analýzu expanze, ekonomiku na úrovni produktů. Naceň ji znovu, se strojem, který ji spočítá přes noc, a člověkem, který ji dvacet minut kontroluje. O tomhle rozdílu je celá přednáška. A to okno je otevřené právě teď.
Další čtyři aplikace se do přednášky nevešly. Shopping report, který ti Google nedá, s vyhledávacími dotazy na úrovni jednoho produktu, už je sepsaný. Marže v konverzích, odvozené feedy a slevové kódy čtené na pozadí jsou na cestě.
Vezmi si celou prezentaci s sebou
Všech 67 slajdů z přednášky na PPC campu 2026 v PDF. Nech mi e-mail a soubor je tvůj.
Jeden soubor, jeden seznam. Píšu, jen když je co číst.
Časté otázky
Proč MCP server a ne rovnou volání API platforem?
API je napsané pro program, který předem ví, co chce. Model se rozhoduje až za běhu. Pustit ho rovnou na API by znamenalo nechat ho psát a spouštět kód proti živému účtu klienta. Náš server mu místo toho dává recepty. Ty obsahují povinná pole a limity a na každé platformě vypadají stejně.
Co brání AI, aby rozbila účet?
Pravidla jsou v kódu, protože prompt je jen prosba. Operace mazání neexistuje. Každý zápis běží nejdřív nanečisto. Účet se před zásahem zkontroluje a každý specialista má strop útraty. Navíc se každý návrh schvaluje řádek po řádku. Řádek, který nikdo neschválil, se nikdy nespustí.
Jaká data klientů jdou do modelů?
Žádné jméno, e-mail, adresa ani telefon. Zákazník je interní ID, které nejde spojit s konkrétním člověkem. Do modelů jde ekonomika objednávky a chování kohort a segmentů. Všechno běží na týmových tarifech s podepsanou smlouvou o zpracování osobních údajů.
Jak dlouho trvalo tohle postavit?
Osm měsíců naplno, od ledna do srpnové přednášky. Sedm systémů v produkci, asi 810 000 řádků kódu v živých systémech a zhruba dvacet lidí, kteří je používají. Bez AI bych jen samotný orchestrátor nacenil na dva až tři roky vývoje.
Je video původní záznam přednášky?
Ano. Přednášku natočil uLab přímo na PPC campu a zveřejnil ji na svém YouTube kanálu. Pro čtenáře, kteří neumí česky, jsem ji ze zvukové stopy a slajdů postavil znovu v angličtině, namluvenou klonem mého hlasu.